
1. 為什麼把內容解密後,程式還是不能直接使用?
可以把受保護程式想成一本加密的操作手冊:解密後看得見步驟,但步驟裡的工具與材料名稱仍被換成代號。必須知道每個代號真正指什麼,才有辦法照著執行。
在 .NET 裡,方法內容主要是 IL 指令;欄位、方法、型別等資訊則放在 metadata。指令使用 token 指向這些資料。本次遇到的 HVM 參照會讓指令使用虛擬 token,由保護 runtime 在執行時轉回真正對象。
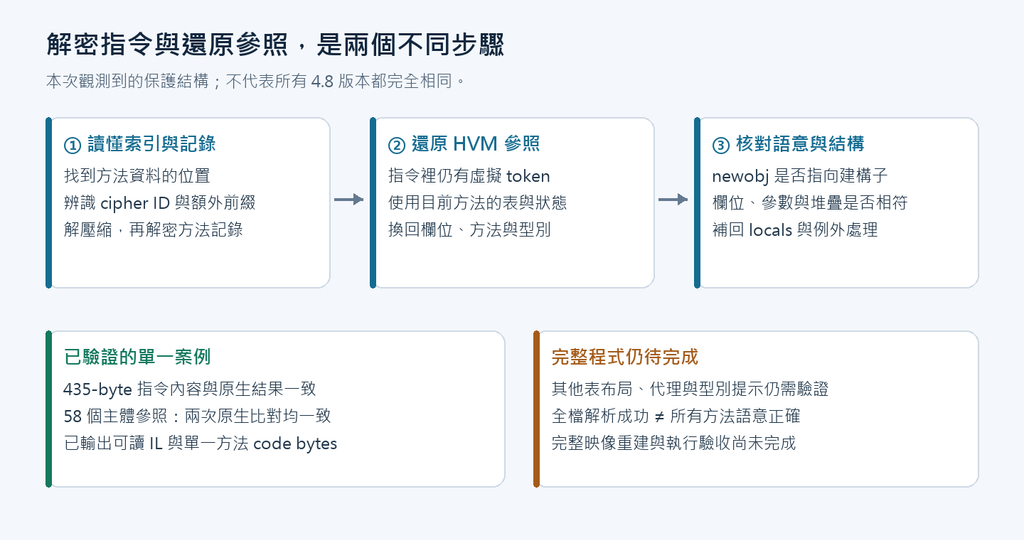
因此工作分成三層:讀懂記錄、解密指令、還原參照,再核對整體結構。
2. 先讀懂「每段內容放在哪裡」
保護資料有索引與記錄,可以理解成目錄和內文。即使解密算法正確,只要起始位置或長度錯了一點,輸出也會完全不對。
本次確認的差異包括:
- 索引的一段鏈式 XOR 只處理前 9 bytes,舊解析方式卻處理前 20 bytes。
- 方法描述子是 4-byte packed DWORD,不是舊解析方式預期的六位元組格式。
- 描述子的低 5 bits 表示 cipher ID,其餘位元用於方法記錄的位移資訊。
- 索引的 bit 27 表示記錄前另有 4-byte 前綴,取資料時要跳過。
- 方法主要標頭為 8 bytes,提供長度或區域變數/例外處理資料位置,以及 HVM 表位置等資訊。
這裡的 packed 是「把多種資訊塞進同一個數字」的意思。例如下面只是描述子低位拆解的簡化示意:
descriptor = (offset << 5) | cipherId

cipherId = descriptor & 0x1F
offset   = descriptor >> 5
實際使用還要配合索引旗標與記錄基底。這個描述子的 packed,與後面 HVM 轉換產生的 packed,是兩種不同資料。
3. 解密方法指令,並用原生內容核對
讀對記錄後,依其 cipher ID 選擇解密流程。不同 ID 不一定能直接套用舊版本算法;例如本次遇到的 XTEA 變體就包含額外運算。
目前先以保護 runtime 的原生函式作為解密依據,再核對產生的內容。選定案例的離線方法內容為 435 bytes;原生 JIT 收到 455 bytes,其中前 20 bytes 是該案例的 runtime 保護前綴。
原生 JIT 內容: [20-byte 保護前綴] [435-byte 方法主體]
離線解密內容:                    [435-byte 方法主體]
                                  └─ 逐位元組完全一致
這支持「方法主體已解密正確」,但不表示裡面的虛擬 token 也已經還原。20-byte 前綴是此案例的觀測結果,不能任意套用所有方法。
4. HVM token 如何變回真正參照?
一般 metadata token 可以拆成「表種類+列號」。例如 0x040005A7 的 0x04 表示 FieldDef,0x0005A7 表示該表的列號。
虛擬 token 不能直接照這個規則讀取。必須配合目前方法的 HVM 表、表項順序與保護狀態進行轉換。同一個虛擬 token 在其他方法出現,不能直接沿用這裡的對照。
本次確認缺少的關鍵,是位元組重排前的「遞增 XOR」:
N = 目前 HVM 表的項目數量
i = 本次表項索引,從 0 開始

x = tableWord[i] XOR (N + i)
XOR 是逐 bit 運算:兩個 bit 相同得到 0,不同得到 1。例如 0x52 XOR 0x3A = 0x68。表長是 58 時,第一筆使用 58、第二筆使用 59,依此類推;漏掉這一步,後面即使仍能算出一個數字,也可能指錯成員。
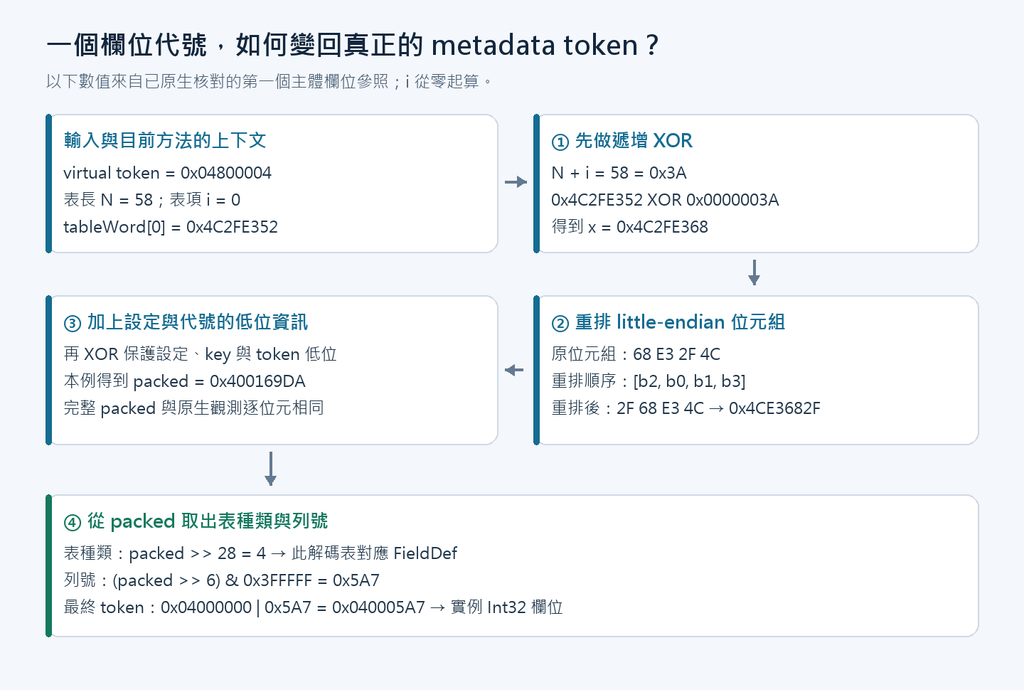
完整轉換概念如下。LE32 表示把四個位元組按 little-endian 組回 32-bit 數值,tokenBases 是解碼用的表種類對照表。
x = tableWord[i] XOR (N + i)

把 x 拆成 little-endian bytes:[b0, b1, b2, b3]
p = LE32([b2, b0, b1, b3])

packed = ProtectionSettings
         XOR (Encryption_Dword AND 0x0FFFFFFF)
         XOR p
         XOR (virtualToken AND 0x000FFFFF)

tableTag = packed >> 28
rowId    = (packed >> 6) AND 0x003FFFFF
token    = tokenBases[tableTag] OR rowId
這個 tableTag 要經過對照表,不能一律直接當成 metadata token 的最高位元組。上圖案例的 packed 為 0x400169DA,解出表種類 4、列號 0x5A7,最後得到 0x040005A7。最低 6 bits 沒有納入列號;本次比對仍保留完整 packed,避免忽略旗標差異。
舊公式在本例的完整 packed 比對為 0/58;補上遞增 XOR 後,兩次獨立原生觀測都是 58/58。
5. 從 IL 看「參照還原」究竟改了什麼
IL 指令不只說「做什麼」,也要說「對誰做」。以下是同一段指令的概念對照:
還原前:
ldarg.0                   // 把目前物件放上堆疊
ldc.i4.0                  // 把整數 0 放上堆疊
stfld 0x04800004           // 寫入哪個欄位?仍是虛擬代號

還原後:
ldarg.0
ldc.i4.0
stfld 0x040005A7           // 已確認為目前類別的實例 Int32 欄位
它的語意可理解成 this.某個整數欄位 = 0。stfld 會消耗堆疊上的物件與數值,因此目標必須符合實例欄位存取;若誤指到另一個類別的靜態常數,即使 token 存在,語意仍然錯誤。
另一個已核對的案例是 newobj:虛擬參照還原後指向接收字串與字串陣列的 WebSocket 建構子。這時必須確認它是 .ctor,而且呼叫端提供的參數與建構子的 signature 相符,不能只確認它是「某個方法」。
6. 怎麼知道結果真的對?
先在隔離環境觸發目標方法的 JIT 編譯,觀察 runtime 解析 token 時的輸入與輸出,再用離線算法計算同一筆資料。這次未呼叫目標方法本體,但有執行 runtime 與模組初始化。
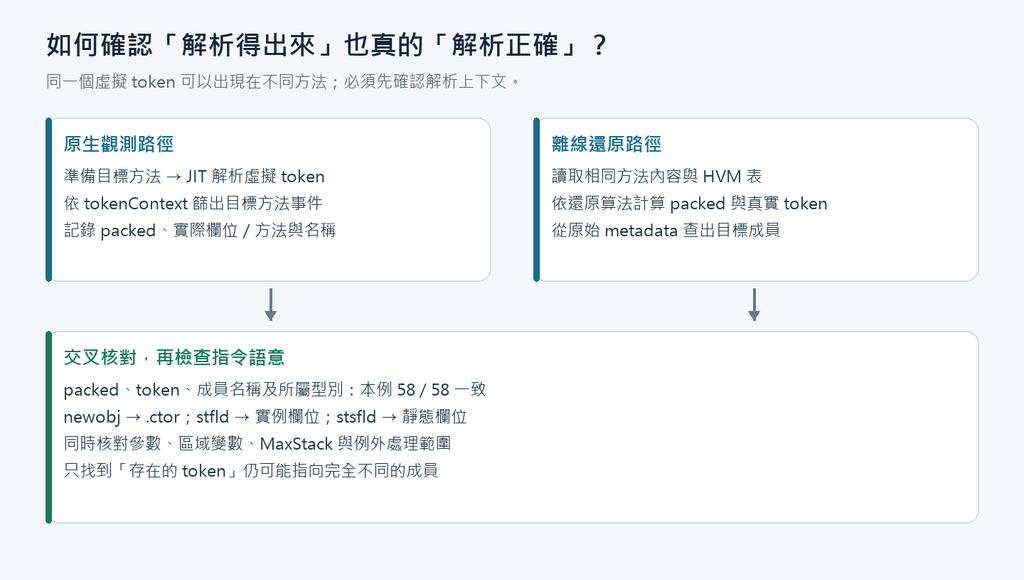
原生 trace 會混有其他方法與保護前綴的事件,因此需要以方法上下文 tokenContext 篩選;不能取第一個相同 token 的結果就當成答案。
本例除了 58 個完整 packed 與 token,還核對了成員名稱、所屬型別,以及:
- 5 個建構子與 23 次欄位存取:確認目標種類及靜態/實例屬性。
- MaxStack = 3:計算指令需要的最大堆疊深度,與原生值一致。
- 9 個區域變數:與原生 CLR 型別分類一致;原生 getter 無法提供完整 class name,因此完整名稱仍取自原始 signature。
- 1 個 catch:確認例外型別及範圍;比較原生位置時加上 20-byte 前綴造成的位移。
例外處理範圍也有座標問題:離線主體的 try 從 offset 1 開始,放回含前綴的原生內容就是 offset 21。若忽略前綴,即使解密內容正確,也可能把處理區段標到錯誤位置。
留言